Groq: 为AI推理而生的性能之王!
近日,AI芯片初创公司Groq推出最快的大模型推理芯片LPU,这是谷歌TPU团队原班人马为大模型推理研发的专用ASIC芯片,基于Groq芯片的推理API也开始向外界开放。
Groq凭实力干翻英伟达GPU
近日,AI芯片初创公司Groq推出最快的大模型推理芯片LPU,这是谷歌TPU团队原班人马为大模型推理研发的专用ASIC芯片,基于Groq芯片的推理API也开始向外界开放。
开发者可在公司官网上(https://wow.groq.com/)申请免费试用,也可以在Poe上免费体验Groq:https://poe.com/Mixtral-8x7b-Groq 。
目前提供Llama-70B-4K和Mixtral-8x7B-32K两种超大尺寸的模型供选择,推理API完全兼容OpenAI的API。
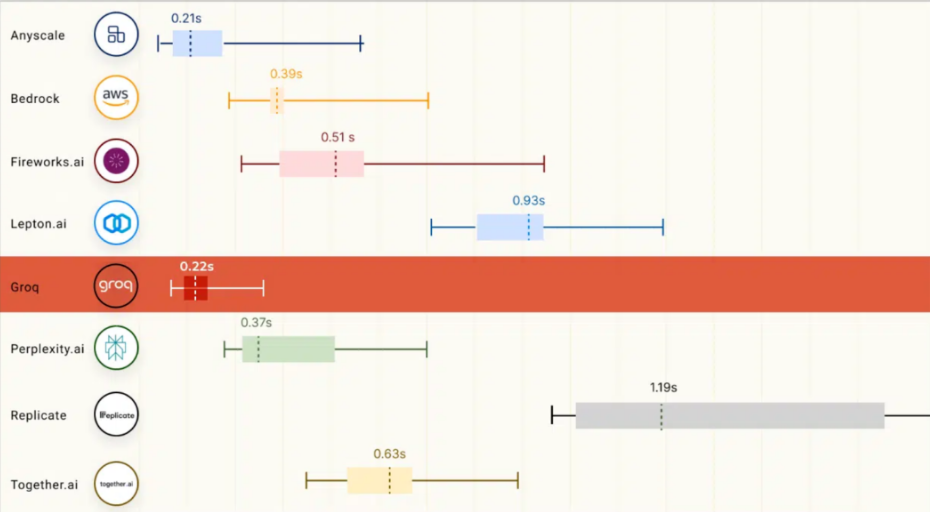
令用户惊叹的是,基于Groq LPU的AI推理速度相当炸裂,比如在问答场景中,使用Llama 70B模型,用户从提问到收到回答几乎没有感受不到延迟,首词输出的时延仅有0.2秒,500多个单词在大约一秒的时间内全部生成,而相同数量的内容,ChatGPT需要近10秒才能生成完,首词输出更是以秒计。
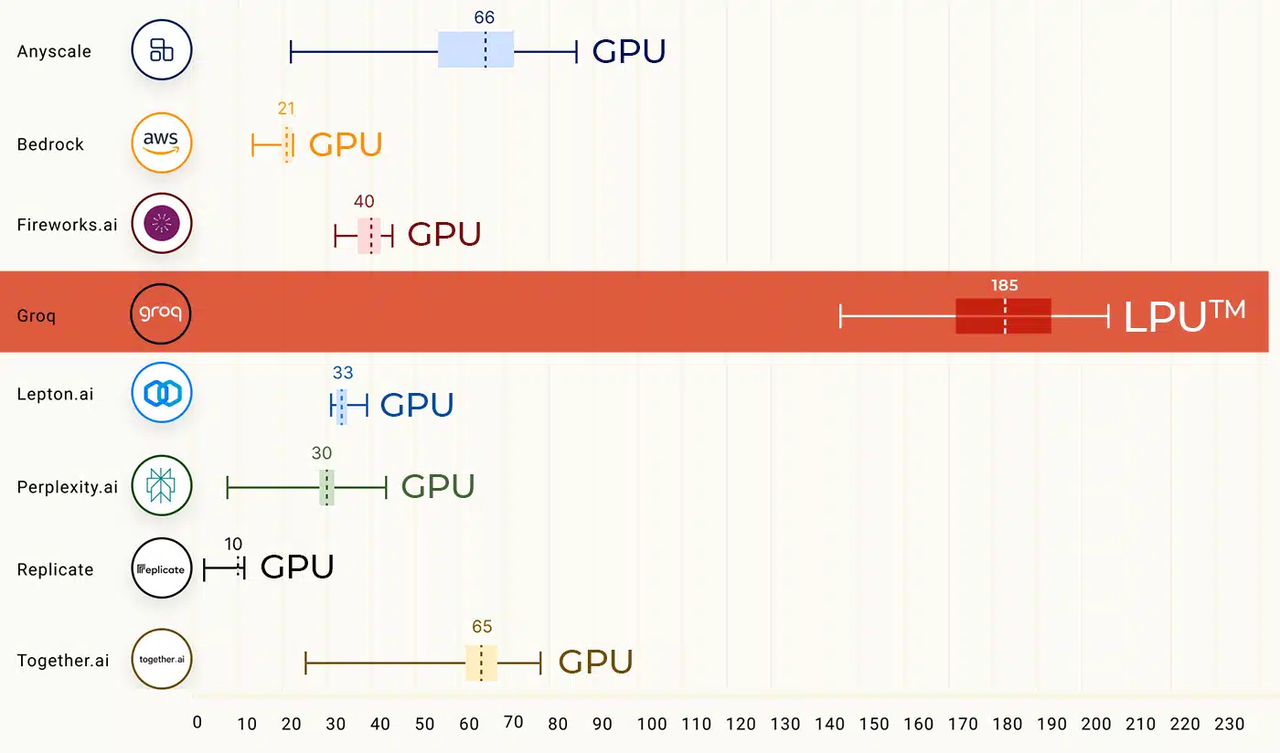
具体到吞吐指标,Groq给出一组对比数据,如下图所示,与行业内优秀选手相比,Groq LPU大约领先10倍左右,完全吊打基于英伟达GPU的推理产品。
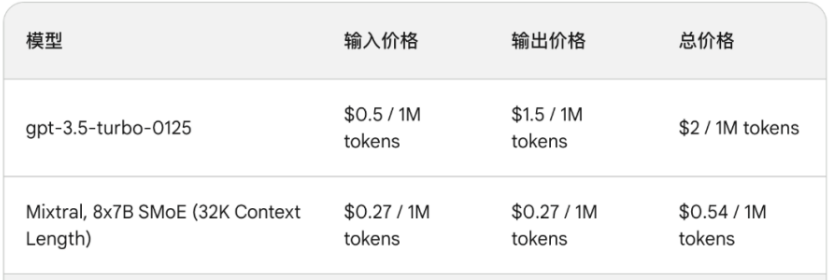
Groq LPU主要是为大模型推理场景而设计的,尤其在有大量用户并发访问的场景下表现更好,卓越的推理速度也意味着更低的推理成本,从Groq发布的推理价格看,其定价已是行业最低,Mixtral-8x7B MoE模型与GPT-3.5相比价格大约便宜4倍左右。
据介绍,Groq LPU推理速度相较于英伟达GPU提高了10倍,成本却降低到十分之一,性价比提高了100倍,可谓"既快又便宜",在速度和成本两方面满足用户需求。
关于成本有一个很大疑问,官方给出的推理价格很便宜,但很多人看到一张Groq LPU卡2万美元的售价会自然产生怀疑,Groq如何在如此高的单卡售价下能做到领先行业的推理价格呢?
这里以Llama-70B为例推测其成本构成:运行一个Llama-70B的大模型,大约需要256张Groq LPU卡的配置,相当于4台服务器机架,每台机架容纳64张LPU卡,相比之下,一台八卡的H100 GPU服务器也可有效运行这个模型。
但从硬件成本上看Groq LPU服务器比英伟达要贵的离谱。
合理的解释是,一方面Groq LPU卡的官方售价虚高,未来一定会大幅下降,让用户的本地部署TCO成本与英伟达服务器持平,另一方面这种配置比较适用于有大量用户并发访问的场景,通过高吞吐大并发的做法将单个用户的单次请求成本显著降下来。
推理请求的高并发性由Groq LPU底层独特架构决定的,其内存单元与向量和矩阵功能单元交错,从而可以利用机器学习工作负载固有的并行性对推理进行加速。
在运算处理的同时,每个TSP都还具有网络交换的功能,可直接通过网络与其他TSP交换信息,无需依赖外部的网络设备,这种设计提高了系统的并行处理能力和效率。
不同于英伟达GPU需要依赖高速数据传输,Groq LPU在其系统中没有采用高带宽存储器(HBM),而是使用SRAM,其速度比GPU所用的存储器快约20倍,这种设计也能够显著提高吞吐量。
在开发软件栈方面,Groq LPU支持通过PyTorch、TensorFlow等标准机器学习框架进行推理,此外Groq还提供了编译平台和本地化部署方案,使得用户根据特定场景利用Groq编译器编译自己的应用程序以获得更好的性能和延迟指标。
Groq的独特硬件架构,让性能领先10倍
Groq的成员来自原谷歌的TPU核心团队,他们对AI芯片的设计具有独到的理解和行业认知,这种认知最终体现在Groq LPU的设计理念上:主张"软件定义硬件",即采用单一核配置计算和存储单元,所有操作均通过软件设定。
这种架构被称为TSP(张量流处理器,Tensor Stream Processor),从硬件层面来看,其设计相对简洁,去除了所有非必需的控制逻辑,将所有控制交由软件编译器完成,从而优化芯片面积分配,实现更高的单位面积算力。
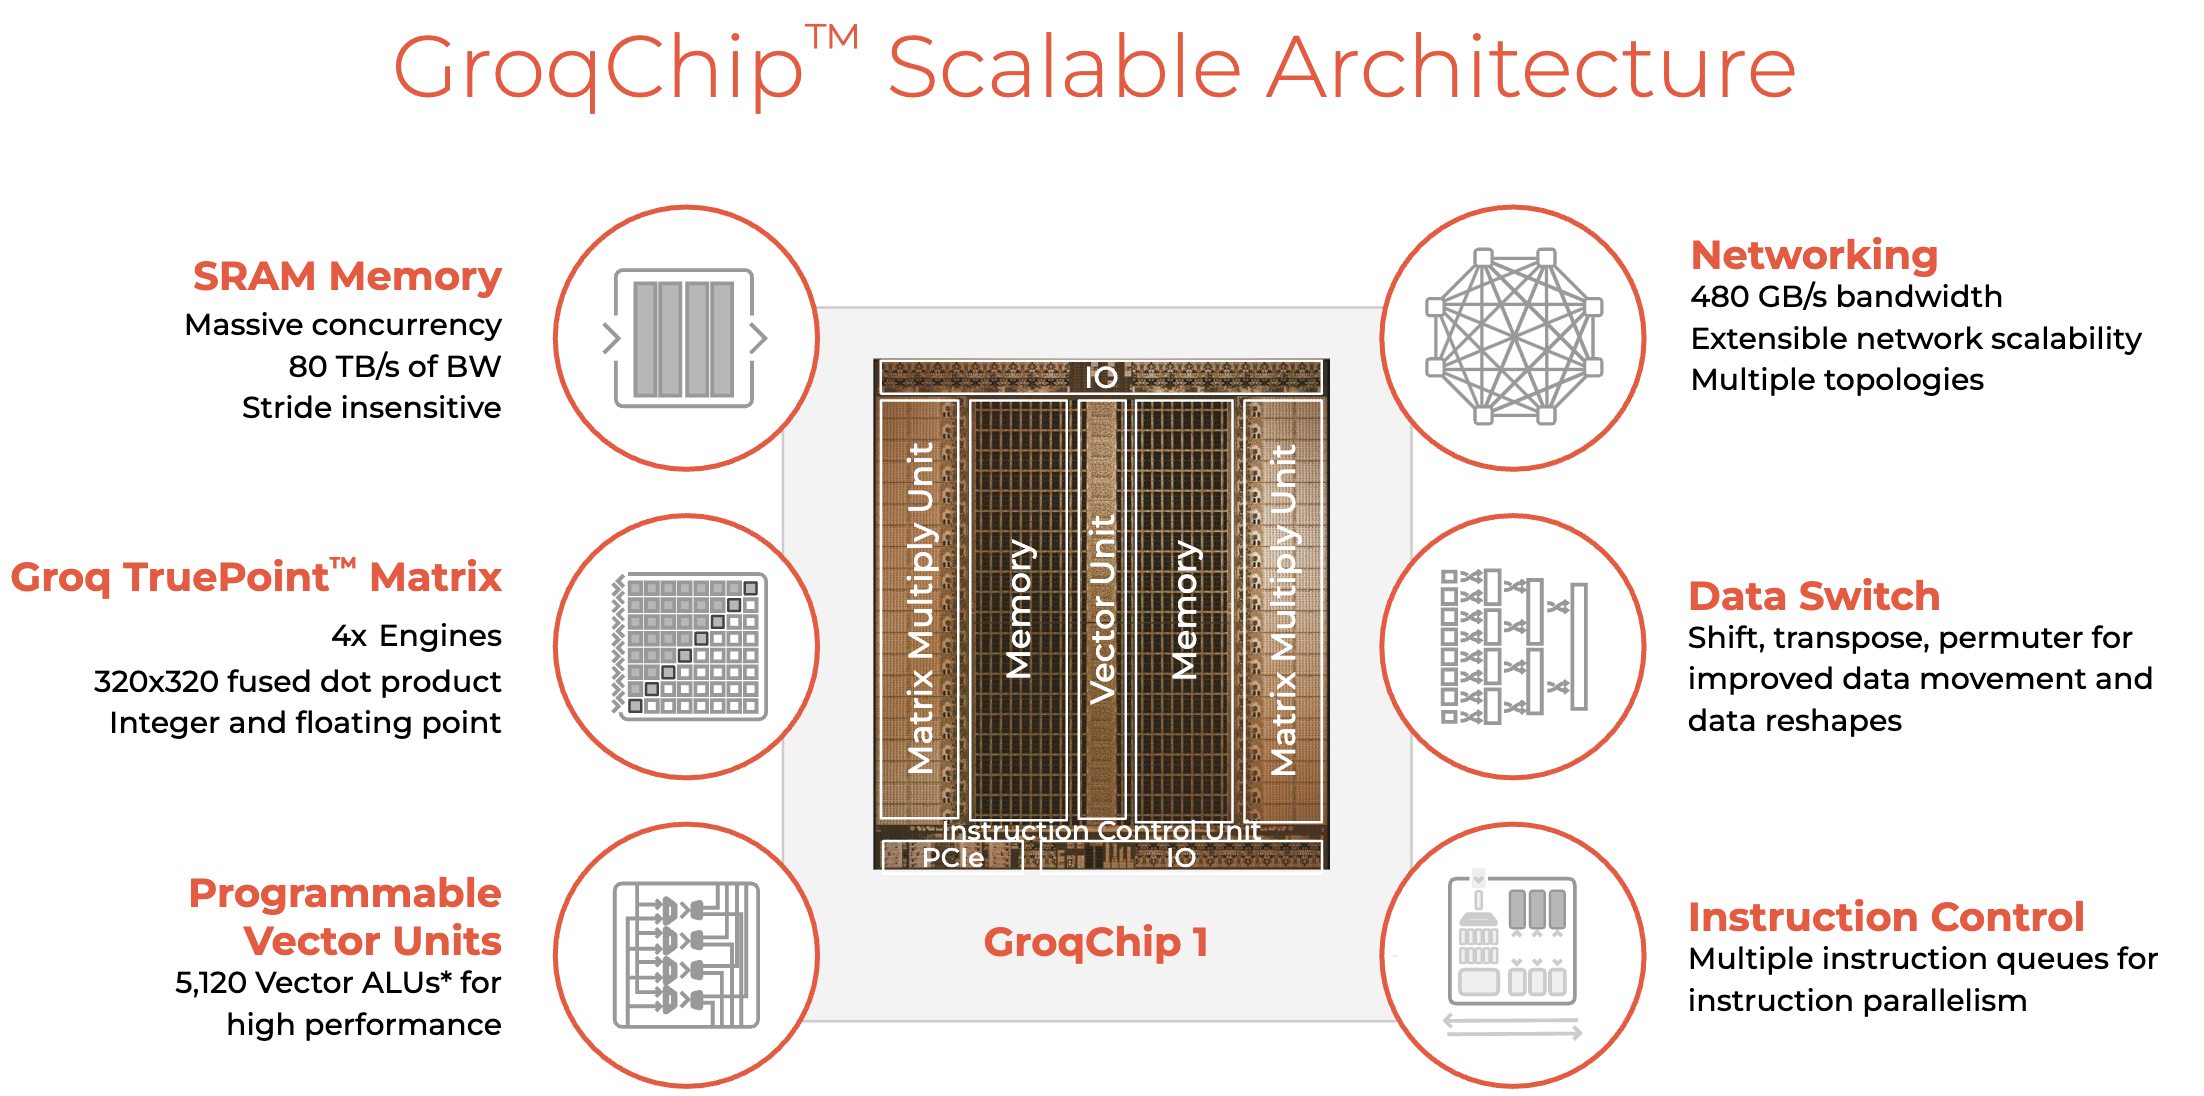
这种硬件设计架构简单,摒弃了无益于AI计算的冗余电路,抛弃DRAM、HBM及CoWoS封装工艺,直接使用SRAM高性能存储,保持较高的内存带宽同时让级联扩展更容易,能够支持更大密度的集群配置,尤其适用于大模型推理这种高性能、低时延、和计算密集的场景。
Groq LPU所采用的TSP架构通过其软件定义硬件的方法,专门针对机器学习和深度学习任务的高效执行进行了优化。
它通过静态和动态分区、以及优化的SIMD功能单元布局,提供了一种高度定制的计算环境,使得编译器能够在编译时完全控制硬件,实现了对执行流程的精细管理和优化。这种方法不仅增强了计算的确定性,而且通过减少运行时的不确定性,提高了效率和性能。
与此相对,英伟达Nvidia A100采用的Ampere架构设计为广泛的计算任务提供支持,包括但不限于机器学习。A100的Tensor Core技术和对多种数据类型的支持确实为深度学习提供了强大的加速,但TSP的专门优化使其在机器学习任务上可能提供更优的性能和能效比。
TSP的设计理念在于为特定的工作负载提供量身打造的解决方案,从而在这些任务上实现超越通用GPU架构的性能表现。
在芯片设计上,Groq采用空间方向排列,功能单元相邻布置,通过彼此之间传递操作数和结果来协作,形成一种称为“链条化”的高效运作方式,使得一个功能单元的输出可以直接连接到相邻下游功能单元的输入。其核心是大型MXM模块,包含409,600个乘加器,利用芯片上的数据并行处理能力,提供每平方毫米超过1 TeraOps的计算密度。
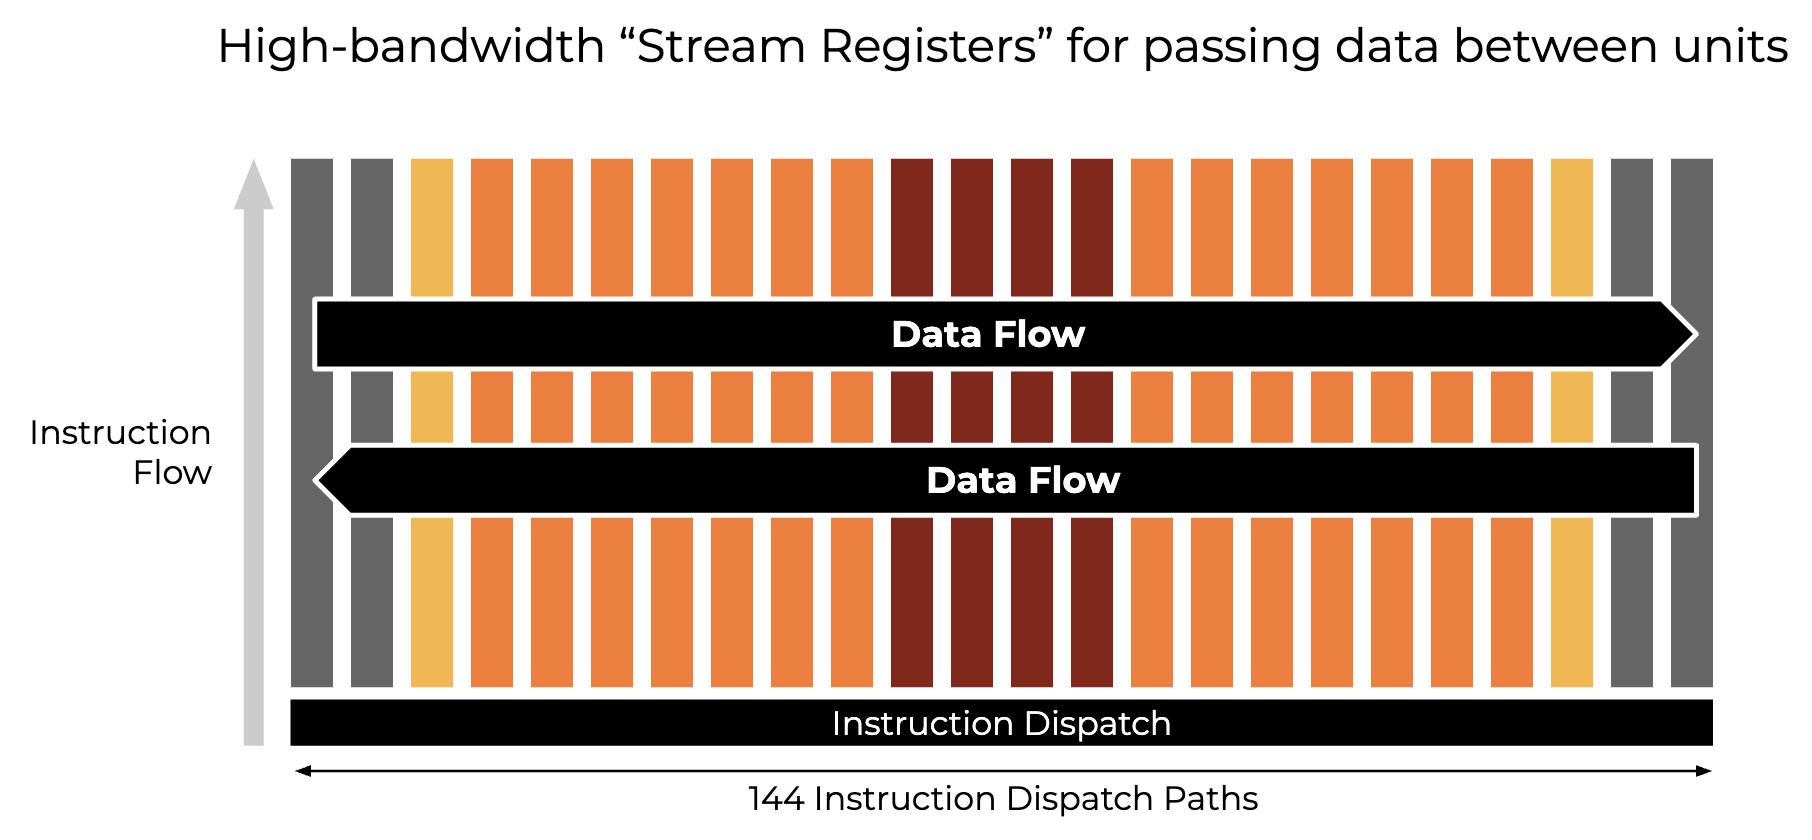
GroqChip的抽象构造展示了多个不同功能单元,如320元素长度的SIMD单元、矩阵单元MXM、用于逐点运算的vector单元、用于数据重塑的SXM单元以及处理片上存储的存储器单元,这些单元被简化成易于控制的构建块。
芯片上采取东西向流式传输数据,优化空间局部性,捕获数据流的局部性,对于机器学习模型尤为重要。
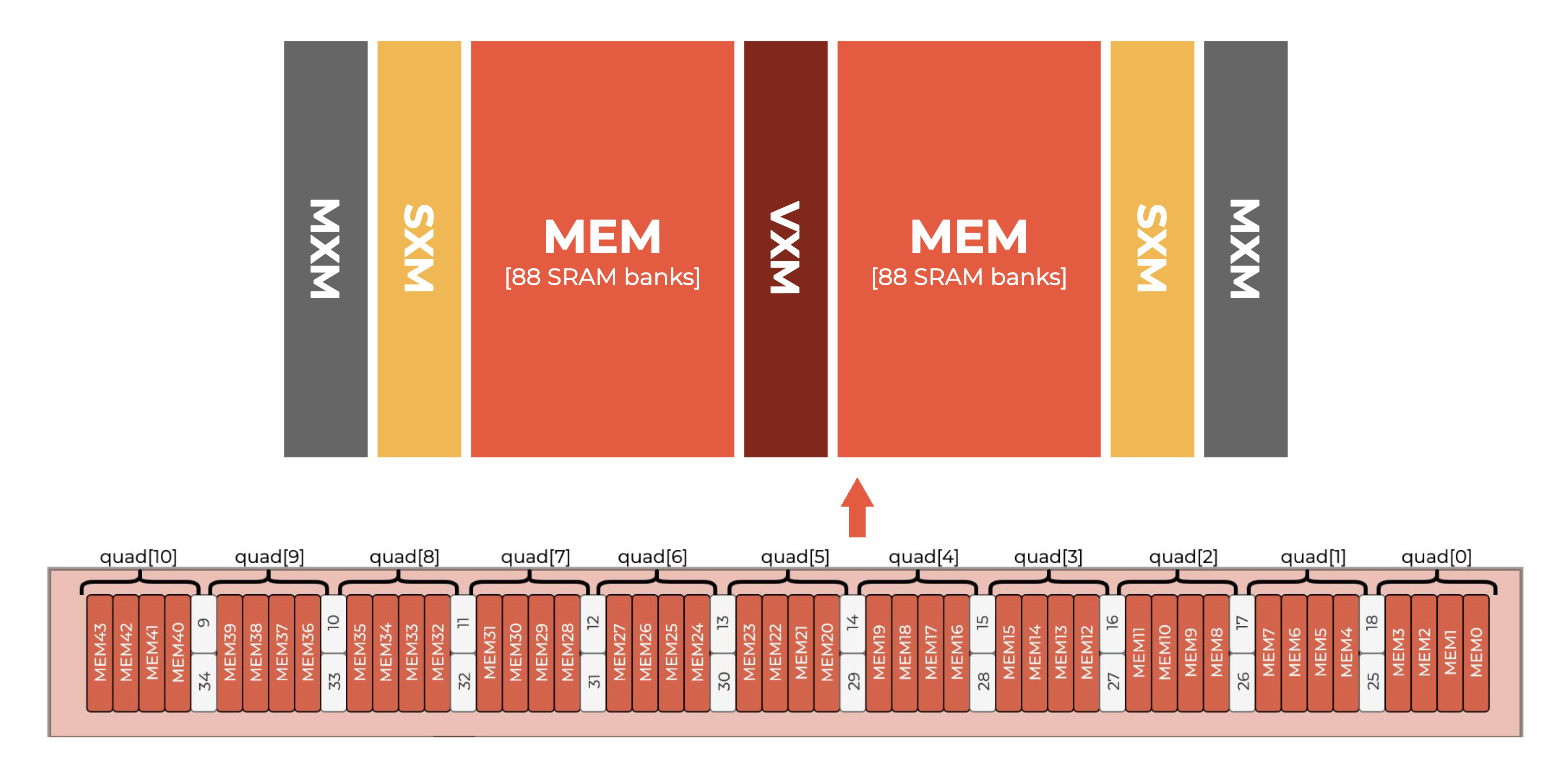
在存储器选择上,Groq的LPU设计中并未采用高带宽存储器(HBM),而是选择了静态随机存取存储器(SRAM),后者在速度上大约快于GPU使用的HBM约20倍。
这种设计选择反映了Groq对AI推理计算的优化策略,尤其是在考虑到AI推理相对于模型训练的数据需求量通常较小的背景下,Groq的LPU通过减少对外部内存的依赖,实现了更高的能效。
此外,Groq的LPU采用的时序指令集计算机(Temporal Instruction Set Computer, TISC)架构,与依赖HBM进行高速数据传输的GPU在工作原理上有本质的不同。
TISC架构的一个关键优势在于其减少了从内存中加载数据的频率,这不仅有助于缓解HBM供应短缺的问题,还能有效降低系统成本。
在AI处理场景中,Groq的LPU因其对存储速度的较低要求,提供了一种无需为Nvidia GPU配置特殊存储解决方案的替代方案,展示了在特定应用场景下的成本效益和性能优势。
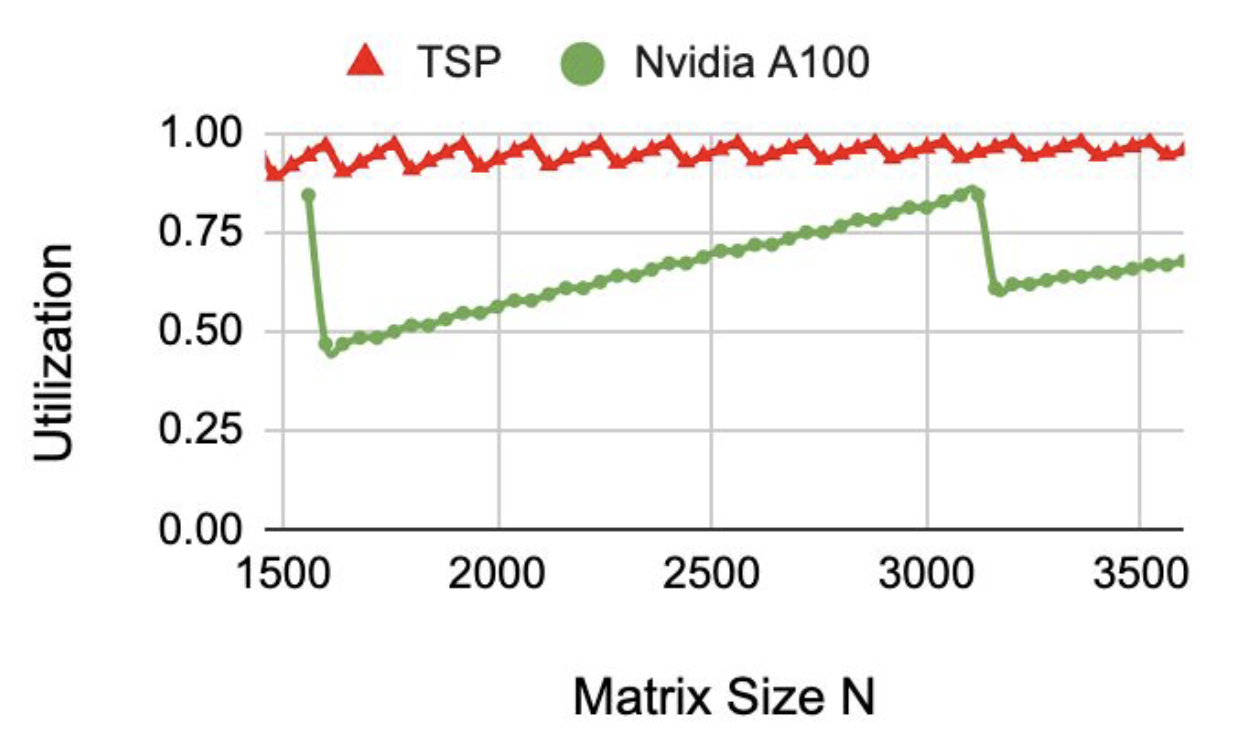
与当前常用于推理任务的N卡A100和4090对比,LPU带宽高达80 TB/s且具有相对较低的功耗
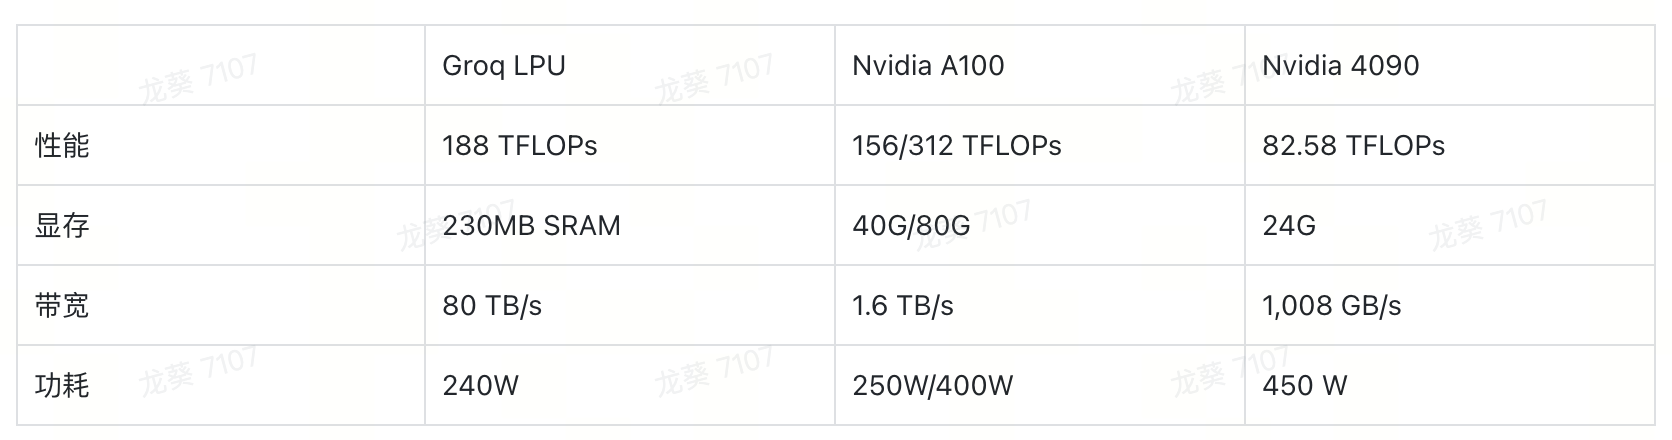
高带宽为LPU提供了更高的计算单元利用率,与A100相比,Groq LPU在GEMM(通用矩阵乘)中利用率几乎打满:
从Groq看AI Infra的发展趋势
在Groq LPU推出之前,大模型训练和推理都是基于英伟达GPU来设计的,采用的CUDA软件技术栈。相应的AI Infra技术基本都围绕英伟达GPU和CUDA生态做软件层优化。
而Groq LPU的推出让我们看到了一些明显的变化,不妨对AI Infra技术的发展趋势做一些预测。
首先,AI芯片的主战场将由训练转向推理,未来一年AI推理市场将大幅增长。相较于AI训练,AI推理与用户终端场景需求更加紧密,训练后的大模型需要通过AI推理服务于实际的场景,目前基于英伟达GPU的AI推理方案依然成本高企,在性能、时延等方面严重影响用户使用体验。
Groq LPU推理卡从硬件上解决性能和成本问题,让AI推理服务大规模部署成为可能,将会有更多的AI推理类应用落地。
同时,AI推理需求的增长也会进一步带动云端推理芯片的增长,尤其是更多的可替代英伟达GPU的新一代专用推理芯片将会出现在数据中心。相应的基于云端的AI训练芯片的增长会逐渐放缓甚至萎缩。
其次,针对AI推理性能的优化技术也可能出现范式变化,传统的推理优化技术包括推理框架层的算子融合优化以及基于模型结构的有损优化技术,前者主要是通过CUDA编程将多个算子融合为一个大算子或者按GPU规格重写算子逻辑,从而提高AI算子的执行效率,也包括FlashAttention这类技术通过算法优化减少GPU内存通信的频率减少传输开销从而提高计算密度。后者主要利用大模型权重的特点进行模型量化、蒸馏或稀疏性计算,通过减少计算量来提高效率。
未来随着Groq这类专用推理卡的大量使用,相应的推理优化算法也将面临新的变量,特别是底层算子的优化,传统方法不一定适用,新的优化算法需要基于新的TSP架构重新思考和设计,而"软件定义硬件"的理念会让硬件的调用更加灵活,压榨硬件性能的空间也会更大。
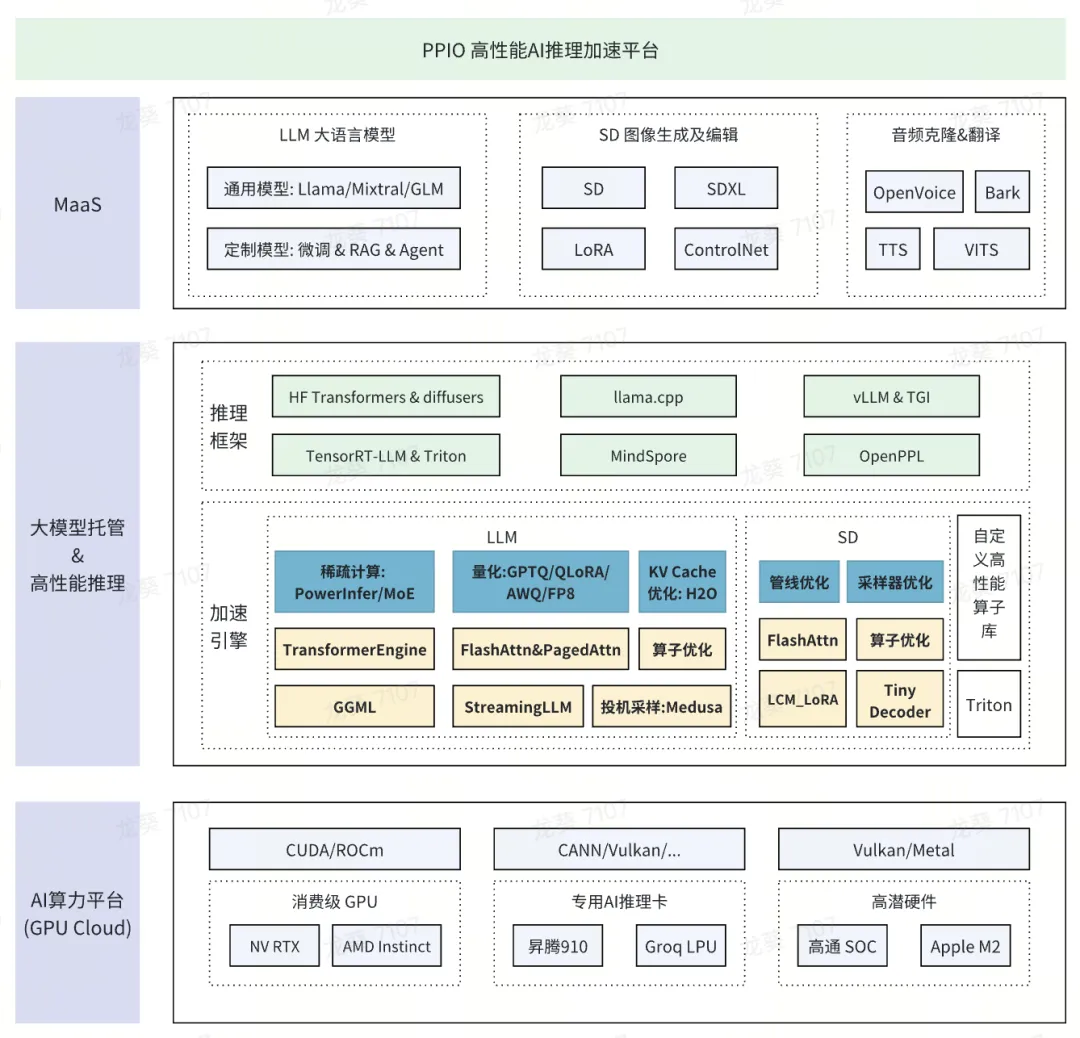
PPIO在AI领域多年发展,已经积累了丰富的AI推理加速优化经验,在经典的英伟达GPU架构下拥有独到的AI推理加速技术,基于PPIO自研的AI Infra平台推出了AI推理服务平台,推理性能和价格优势均保持行业领先,同时我们也在积极探索可替代英伟达GPU的专用芯片的AI推理方案,未来我们将持续关注研究Groq LPU推理卡的产品方案,及时应用到我们的产品中。
此外,AI推理服务的场景将更加丰富多样化,当AI推理的时延达到实时级别时,诸如自动驾驶、机器人等强交互的场景也可能爆发式增长,与中心云相比,运行AI推理服务的边缘云以其超低时延和成本优势将会渗透到越来越多的实时推理场景中。