派欧算力云全网首发4090D,实测性能可达4090的98%!

分享
派欧算力云全网首发4090D,实测性能可达4090的98%!
NVIDIA 推出为中国市场量身定制的 RTX 4090D  显卡(以下简称“4090D”)。

NVIDIA 对该显卡的参数进行了特别调整。RTX 4090D 的设计严格遵循了 TPP(总处理性能)的限制,配备了14592 个 CUDA 核心,加速频率达到 2.52 GHz,并搭载了 24GB 384bit GDDR6X 显存。

参数可以做简单对比,实际性能却不能简单换算,可能面临模型、推理框架、算力墙、显存墙等多种因素影响,端到端的性能评测是一个非常复杂严谨的事情。

借着这次派欧算力云(www.paigpu.com) 4090D 资源上线,我们也为大家提供一份完整的性能评测报告!

NVIDIA 4090D 规格参数解析
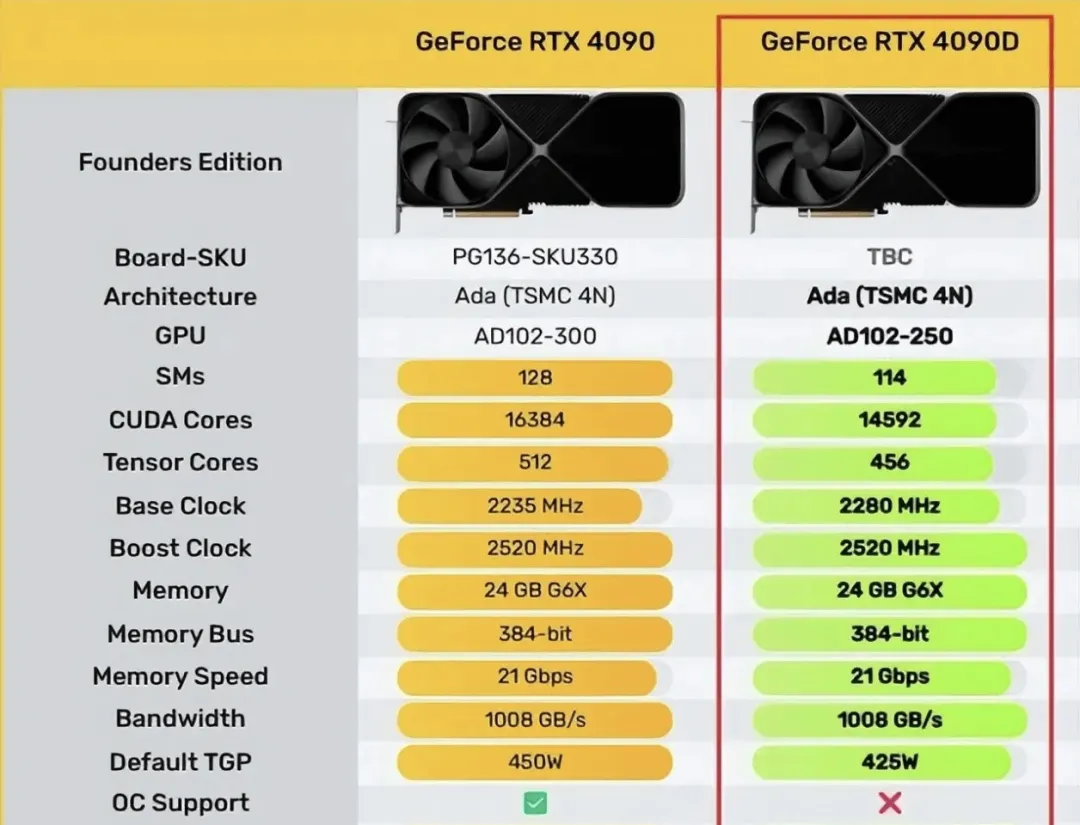
GeForce RTX 4090D采用了 NVIDIA Lovelace 架构,5nm 制程工艺, 配备了 14592 个 CUDA 核心、24GB GDDR6X 内存、384 位宽内存总线和 425W 额定功耗。

与RTX 4090相比,RTX 4090D在核心数量和功耗上有所降低。其中,RTX 4090D 的 CUDA 核心减少了 12.8%,从 16384 个降至 14592 个、128 个流处理器减至 114 个,而功耗也略微下降了5.9%,从450W降至425W。

在其他核心规格上,RTX 4090D 与 RTX 4090 相同。比如,384位的宽内存总线,24GB GDDR6X 显存,以及最高可达2.52GHz的加速频率。唯一的区别是基准频率略有提升,从 2.23 GHz 调整到 2.28GHz,但有点遗憾的是,4090D 并不支持超频。

从性能参数推算,4090D 相当于是发挥了 90% 性能的 4090。

性能评测方法和数据

为了深入了解在实际应用场景中 4090D 的表现,我们选择了当下风靡的 Stable Diffusion (以下简称“SD”)和大语言模型 Llama 对此进行了性能测试。

Stable Diffusion 测试

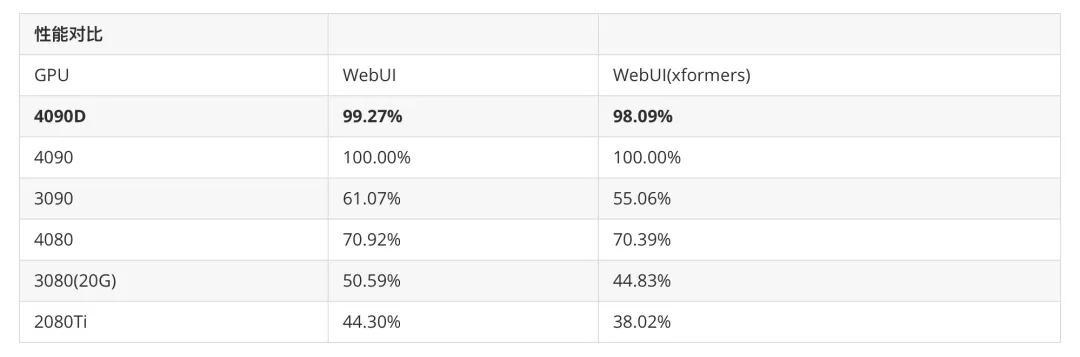
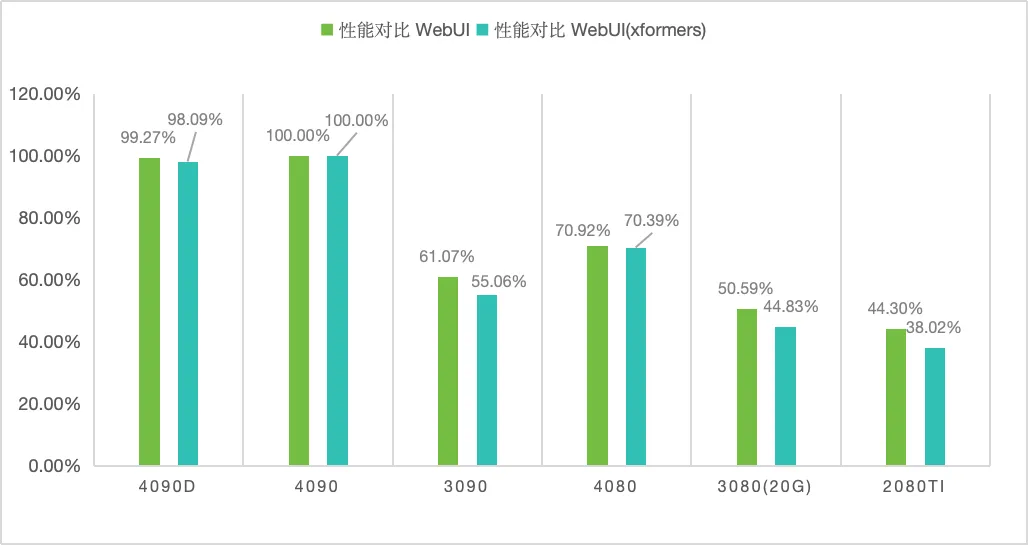
在 SD 测试中,我们以 4090 为基准,同时结合目前市面上热门的其他显卡,制定了两个指标用于衡量 4090D,分别为“单卡性价比”和“性能对比”测试。

SD性能对比方法

在SD_V1.5基础模型,默认采样器,512*512分辨率下,生成每张图的耗时。

SD性价比对比方法

结合算力的时间成本,对比RTX4090与RTX4090D,生成每张图片的价格。

单卡性价比:
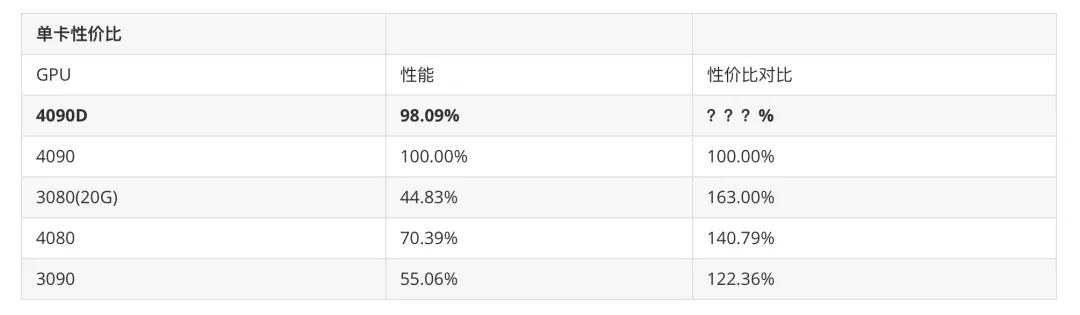
访问派欧算力云(www.paigpu.com)对比 4090D 价格

性能对比:

大语言模型推理(Llama2)

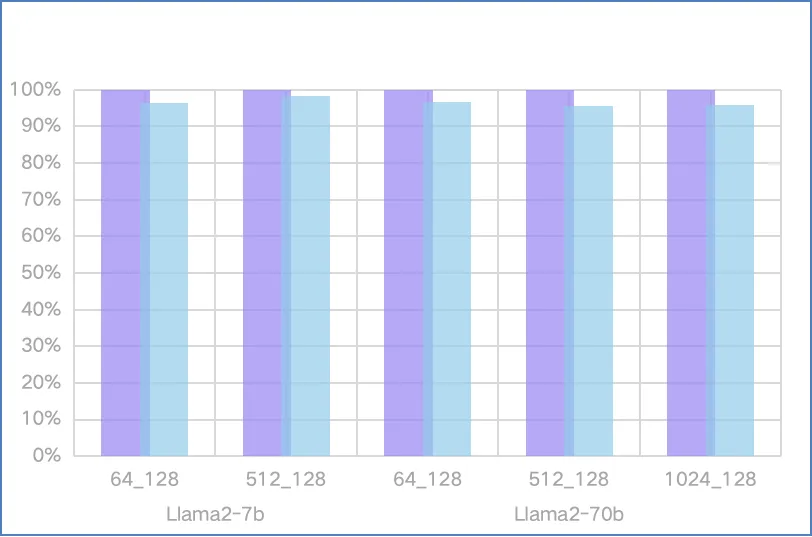
在大语言模型的测试中,我们以 4090 的性能作为基准值,分别选用了不同规格的 Llama 模型进行了多轮测试,最终梳理出了以下结果。

LLM性能对比方法

指定输入/输出参数长度下,对比每秒生成的Token数量。

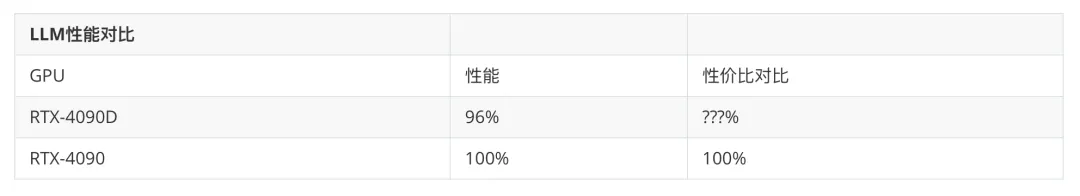
LLM性价比对比方法

结合算力的时间成本,对比RTX4090与RTX4090D,生成每个Token的价格。如每小时算力成本1元,每小时生成Token数为100个,则性价比就是1分钱/Token。

性能对比:
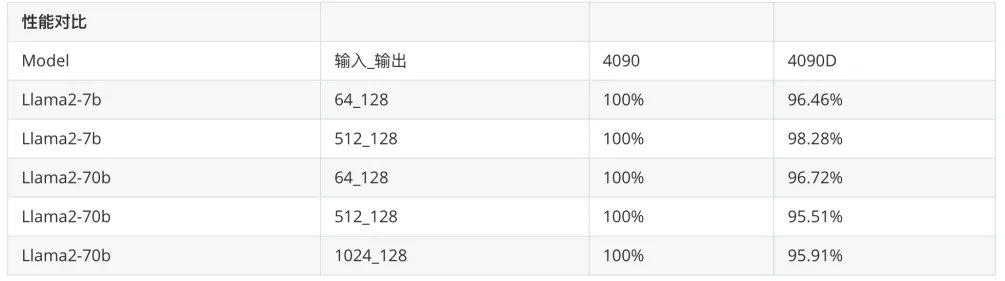
注:Llama-7b 为单卡推理性能,Llama-70b 为八卡推理性能

LLM推理性价比:

评测结论

通过上面的测试数据,我们得出以下结论。

1、在 SD 测试中,4090D 的性能约为 4090 的 98%-99%。

2、在 Llama2-7b 的测试中,4090D 的性能约为 4090 的 96.5%。

3、在 Llama2-70b 的测试中,4090D 的性能约为 4090 的 97%。

试用方法

如果抛开性能,单从机房建设的性价比上来说,在不考虑合规与溢价的条件下,4090D 的整体建设性价比约为 8 卡 4090 服务器的 120%。如今,机器学习、生成式人工智能浪潮席卷全球,不少企业都陷入一卡难求的窘境,此时,选择高性价比的 GPU 云服务受到了越来越多企业的青睐。

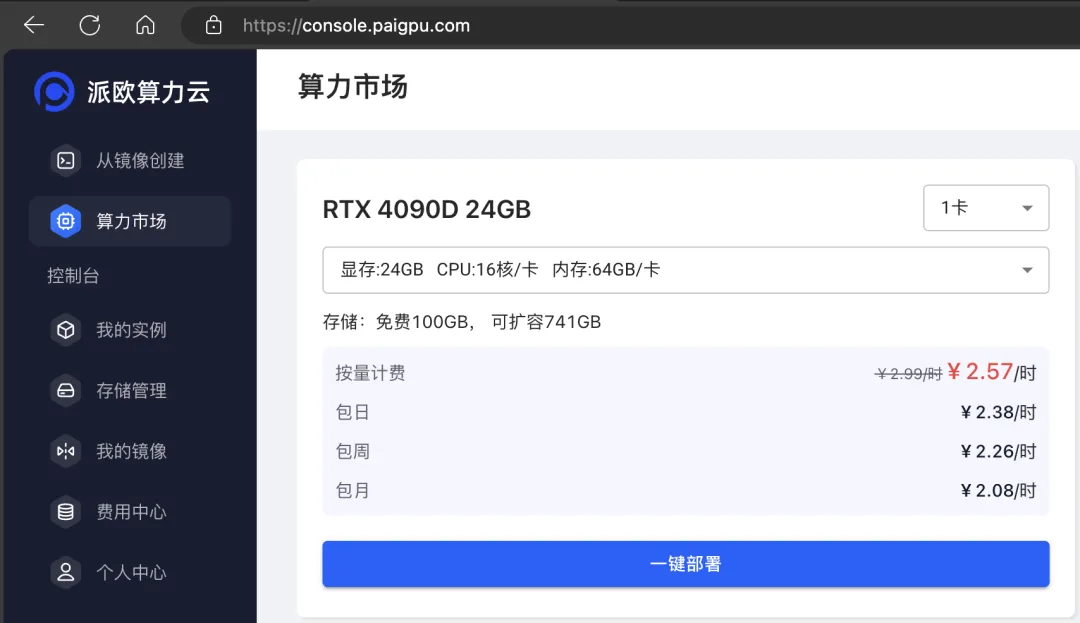
派欧算力云全网首发上线,正式上架 NVIDIA GeForce RTX 4090D ,您可以在算力市场一键部署。按需计费、弹性伸缩的特性,不仅为您免去了高昂的建设成本和运维成本,更有涵盖多种运行环境和应用场景的海量镜像供您选择,您可以根据自己的需求快速选择并部署,大幅节省环境配置的时间,提高开发效率。
阅读更多

几千条商品创意素材,什么时候该用批量推理?

几千条商品创意素材,什么时候该用批量推理?

同一个电商团队,既要让客服马上回复「我的订单到哪了」,又要给三千件商品补写介绍。客服可以用在线调用,在当前会话里拿到答案。商品创意素材可以用 PPIO 批量推理,把已备齐资料的商品集中提交,等结果返回后再交给运营审核。两类任务怎么安排,要看各自的上线期限,以及每条结果能否独立审核和发布。 先看这批工作能等多久 在 PPIO 创建批量推理任务时,可以按固定的 48 小时任务窗口倒排上架时间。批次有可能提前完成,到期时也可以取回已完成的结果。若今天下午才拿到资料、明早就要发布,可以把关键款安排到在线调用,按上架时间把其余款式分批提交。排期时把上传、审核和补跑也算进去。 再看单条请求的资料是否齐全。一件衣服的介绍只用到它自己的尺寸、材质和洗护方式,可以单独提交。如果文案还要写明全店活动的条件,先审核活动说明,再把同一版说明写入各条商品请求。这样每条请求都有完整输入,生成的折扣门槛和活动日期也能按同一版规则核对。 假设周三 12:00 上架,先留 4 小时审核和补跑,再往前留足 48 小时窗口,周一 08:

By luigi
从 E2B 换到 PPIO 沙箱,哪些东西能带走?

从 E2B 换到 PPIO 沙箱,哪些东西能带走?

假设周五切换沙箱,有三份库存报表等着交付。一份还没开始,等新环境验收后再派过去。一份已生成临时文件,可以先让旧环境做完。必须交接时,再导出文件或从原数据重算。第三份的提交请求已经发出,界面仍显示「处理中」,先查财务系统有没有收到。新任务要准备的是运行环境,在途任务还要交接文件和进度。 让现有 E2B 项目接入 PPIO 沙箱 已经在用 E2B SDK 的项目,可以通过 PPIO 的兼容接口创建沙箱、运行命令和管理模板。先选一条常用任务,沿用现有程序试跑。以库存报表为例,从创建沙箱开始,读入订单、执行脚本,再取回成品。这样很快就能确认哪些调用可以沿用,哪些需要接入 PPIO SDK。试跑时,按指南使用支持的 E2B SDK 版本,将连接指向上海 v1 入口 sandbox.ppio.cn,并配置

By luigi
Agent 等多久,暂停沙箱才划算?

Agent 等多久,暂停沙箱才划算?

报表已经生成,用户还要开完会才能确认。此时让沙箱继续运行,买到的是随时可用的状态;把它暂停,节省的是等待期间的计算占用。怎样选择,可以先算一笔简单的任务账。对需要多轮确认的 Agent,最值得优化的往往是两次工作之间的空档。目标是在用户回来时及时继续,同时减少没有产生结果的资源占用。 先算暂停需要跨过的成本 比较两种安排时,把相同的首次执行、最终修改和模型调用费用先放到一边,只看暂停策略改变了什么。净节省可以写成:等待期间免去的计算费,减去新增存储费,再减去恢复、重连和重做的费用。净节省为正,暂停才在这笔任务上带来费用收益。存储应比较两种安排的差额。如果某份持久化数据无论是否暂停都要保存,就不必在暂停方案中再次完整扣除。反过来,暂停产生了额外快照保留,就要把这部分纳入。PPIO 生命周期说明区分运行、暂停与终止:暂停保留文件系统和内存状态,停止计算资源计费;存储费用可在定价说明中分别查看。恢复后,同一任务可以继续使用保留下来的状态。 一小时任务,可以怎样计算 假设首次处理报表用 10 分钟,等待确认 45 分钟,修改用 5 分钟。

By luigi
人接手后,电脑操作 Agent 怎样继续完成任务?

人接手后,电脑操作 Agent 怎样继续完成任务?

人工接管电脑操作 Agent,最重要的体验是“我改完,它能接着做”。如果用户修正了日期,Agent 却继续依据旧画面点击,接管反而制造了第二次错误。解决这个问题,需要把控制权交接设计成一段完整流程。以导出订单为例,用户希望获得指定日期、指定状态的文件。Agent 负责推进操作,用户可以随时纠正条件。交接完成后,双方应当面对同一份页面状态和同一个任务目标。 先让 Agent 停稳,再开放人工操作 任务可以依次经历自动执行、请求接管、人工操作和准备恢复四个阶段。用户发起接管时,调度器停止派发新动作,并处理已经发出的点击或命令;确认没有旧动作继续改变界面后,再交出操作入口。这比简单设置一个“人工模式”标记多了一步。一个已经发出的下载或提交请求,可能仍在后台执行。接管页面应显示正在收尾,随后告诉用户可以开始操作,避免两套动作交错发生。还要区分停止 Agent 的动作循环与暂停整个沙箱。人工修正页面时,桌面需要继续运行;真正进入长时间等待后,才考虑保留状态并暂停计算。把这两个操作分开,用户才能顺利进入原来的工作现场。 用两种桌面入口区分观看与操作 PPIO

By luigi