3.4万亿日均Token调用量,PPIO如何成为企业级Token调用的最佳实践?
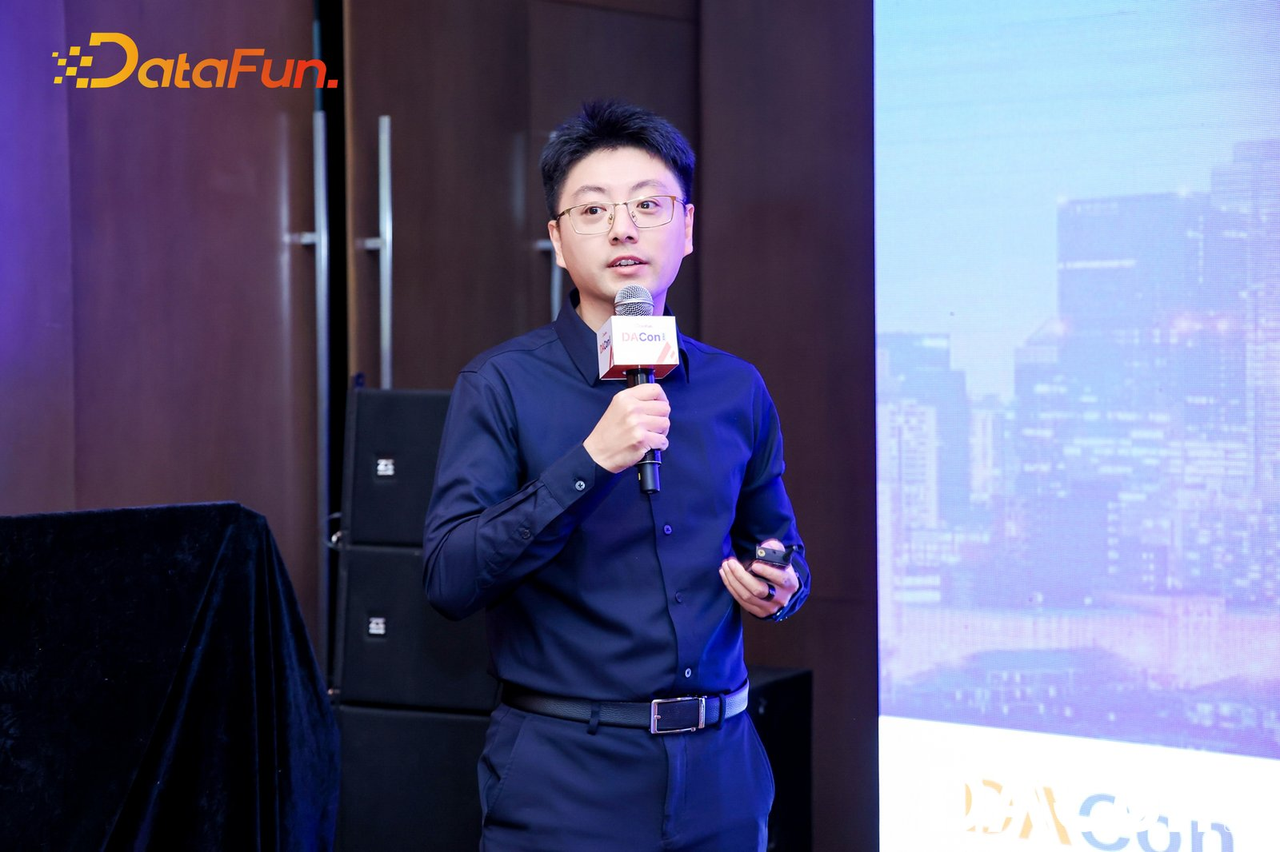
近日,由 DataFun 主办的 DACon 大会北京站圆满举办。PPIO 业务总监厉肃受邀出席,并在「企业模型组合:选型、路由、成本与治理」论坛发表主题演讲《PPIO 的Token 工厂与智能模型网关实践》。
一枚 Token 从任务请求发起,到任务执行结束会经历很多关键流程。PPIO 厉肃从客户使用 Token 的视角,分层拆解请求进入、路由判定、弹性调度、推理生产到任务编排各个环节,完整展示日均 Token 调用量 3.4 万亿背后, PPIO 如何把成本、延迟与智能逐一打磨到位。
- 云的用户变了,Token 之痛随之而来
“云的第一用户,正在从「人」变成「Agent」。”PPIO 厉肃在分享中指出。
与传统云相比,Agentic Cloud 在七个维度上发生了根本性变化——从同步的请求-响应变成异步的自主决策与行动,从分钟级会话变成小时级乃至周级的持续任务运行,从人类手动硬编码调用变成 Agent 自主发现、选择、组合与调用工具,计费单位也从「API 调用次数」变成了「任务完成度与运行时长」。
随之而来的,是「企业调用 Token 的四苦」:Agent 任务越长、调用越多,成本失控;模型平均 3 个月一换、企业要同时对接 10–15 款模型,每次迁移都是工程成本;自己买卡建集群,行业 GPU 利用率均值只有 40–50%,一半算力在睡觉;人用云秒级延迟可以接受,Agent 每次循环几百毫秒、叠加几十上百次就是灾难。
面对这四苦,业界有两条现成的路。
一是公有云自研大模型全家桶,一站式开箱即用,却把企业绑定在单一模型上,无法跨模型取最优;二是企业自建 GPU 集群加开源推理框架,数据可控、自主度高,却要独自扛起 40%–50% 的利用率和繁重的运维。
而 PPIO 走的是第三条路——独立第三方MaaS平台:模型中立、按量付费、弹性调度。
- 四层架构,把智能密度与成本逐一打磨
一枚 Token 从请求进入,要经过至少四个核心阶段:请求判定(模型服务层)→ 弹性调度(调度层)→ 推理生产(推理引擎层)→ 任务编排(Harness 层)。PPIO 的每一层架构,均已获得可靠的市场验证。
第一层:智能模型网关,让每个 Token 跑在最合适的模型上。
PPIO 提出了一个公式:Agent 生产力 = Token 智能密度 × Agent Loop 时长。
智能网关按任务复杂度做路由:关键决策交给 Fusion 融合模型会诊,简单任务自动分流到轻量模型——前者保证智能水平超越闭源 SOTA,后者把成本降到原来的几分之一。
Fusion 融合模型的「专家会诊」机制,让内部 2–3 款模型互相 PK、讨论、校验,在单模型参数之外用工程化方式突破智能上限,成本仅为顶级闭源模型的约 1/10,智能不减半。在 DRACO 深度研究基准 100 题中,PPIO Fusion 以 62.55 分超过 Claude Opus 5.5、Claude Fable 5.1 等闭源旗舰与 OpenRouter Fusion,费用优势同样明显。
第二层:弹性调度,PD 分离与多集群错峰,让算力不睡觉
调度层回答「怎么把算力用满」的问题。PPIO 把 Prefill/Decode 两套物理资源池隔离、独立扩缩容,从底层杜绝资源抢占与延迟抖动;多集群跨业务负载融合、削峰填谷,配合引擎显存能力承载更大的流量波动;调度还会感知请求频次与上下文长度,基于 KV 压缩后的真实可用显存做决策,并联动引擎实时计算并发上限,而不是按最坏情况预留资源。
在弹性调度机制下,PPIO 的 GPU 利用率长期稳定在 75% 以上,且利用率曲线接近一条直线,而行业均值只有 40–50%。
针对不同场景,调度策略也不同:人对人对话追求秒级响应,做低延迟接入和首 Token 延迟优化;Agent 自动调用是毫秒级高频,走 PD 分离 + 长连接 + 高吞吐调度;AI 编程精度优先,走强模型路由 + 高规格算力 + 混合模型会诊。
一句话总结:「不是把单模型做到最快,而是让每一个 Token 都跑在最合适的卡、最合适的模型上。」
第三层:PPInfer 推理引擎,把 Token 生产效率拉满
推理引擎负责「Token 生产效率」,三项自研优化层层递进:全链路 FP8 量化——权重、中间激活、KV Cache 全部 FP8 存储与计算,硬件利用率更高、延迟更低;KV Cache 稀疏压缩——分层动态分配预算,单卡压缩与集群调度联动;投机采样——非固定草稿,在线动态更新草稿模型,越跑越贴合业务分布。
相比主流推理框架,PPIO 实现首 Token 延迟下降 2.5 倍、单卡吞吐提升 3 倍以上、Token 总吞吐量提升 300%+;推理加速效果超越开源社区(Throughput/GPU 分别提升 192%、181%、125%),覆盖 DeepSeek、GLM、Kimi、Qwen 等主流模型。
6 月 16 日,PPIO 入选中国信通院首批「Token 服务能力攀登计划」;通用场景下模型服务实现 TPS ≥ 55、TTFT ≤ 0.9 秒、调用成功率 ≥ 99.9%。
第四层:任务编排,Agent 沙箱与 Token Plan,让长程任务跑得起。
长程任务是成本失控的重灾区,PPIO 用 Agent 沙箱 和 企业 Token Plan 两件产品兜住。
其中,PPIO Agent 沙箱是国内首款兼容 E2B 的沙箱,是 Agent Harness 的核心组件之一,采用系统级安全隔离,让每个 Agent 任务运行在独立虚拟机环境。PPIO 支持上万个沙箱同时创建,冷启动时间小于 200 毫秒,任务空闲时可自动暂停计费,综合使用成本较同类产品降低 90% 以上。
- 被企业客户验证的最佳实践
PPIO 平台目前拥有 68 万+ 注册开发者、3.4 万亿+ 月日均 Token 调用量、75%+ 的 GPU 利用率,覆盖全球 6 大洲 5000+ 算力节点;Agent 沙箱上线一年规模增长 120+ 倍。根据灼识咨询,按日均 Token 消耗量计,PPIO 在中国独立 AI 云计算服务商中排名第一。
落到企业场景,某大型集团用 PPIO 搭建内部 AI 提效平台:法务、HR、财务、研发、客服八个部门统一接入,敏感场景私有部署、合同代码与客户信息不出域,一个 API Key 零改造接入现有 OA 系统。结果是人均提效 30%+、综合成本下降 40%。
为什么客户选择 PPIO?四个理由可被直接感知:
不被锁定——百余款模型同一份 API、切模型只改一行代码,OpenAI、Anthropic 兼容接口可直连 Claude Code、Codex、Workbuddy;更高效的 Token 利用——同样 Token 量成本降 40–50%,简单请求自动路由轻量模型,复杂任务可调度 Fusion 融合模型;更安全——物理隔离满足合规审查、沙箱实现系统级安全隔离;已被验证——日均 3.4 万亿 Token 在线运行、半年调用量翻番。
在 Agent 时代,比谁的模型更会答题更重要的,是谁能让硅基生命跑得更快、更便宜、更稳定。
未来,PPIO 将持续创新,打磨技术和产品,为全球开发者和企业提供高性价比、高稳定、可长时间运行的模型与 Agent 基础设施服务,让每一个 Agent 都用得起、跑得稳、跑得久,助力推动下一次 AI 突破,加速超级智能时代到来。